Über 50.000 CUDA-Kerne und NVLink 7 auf einem Chip: NVIDIA enthüllt die Rubin-HPC-GPU für 2028
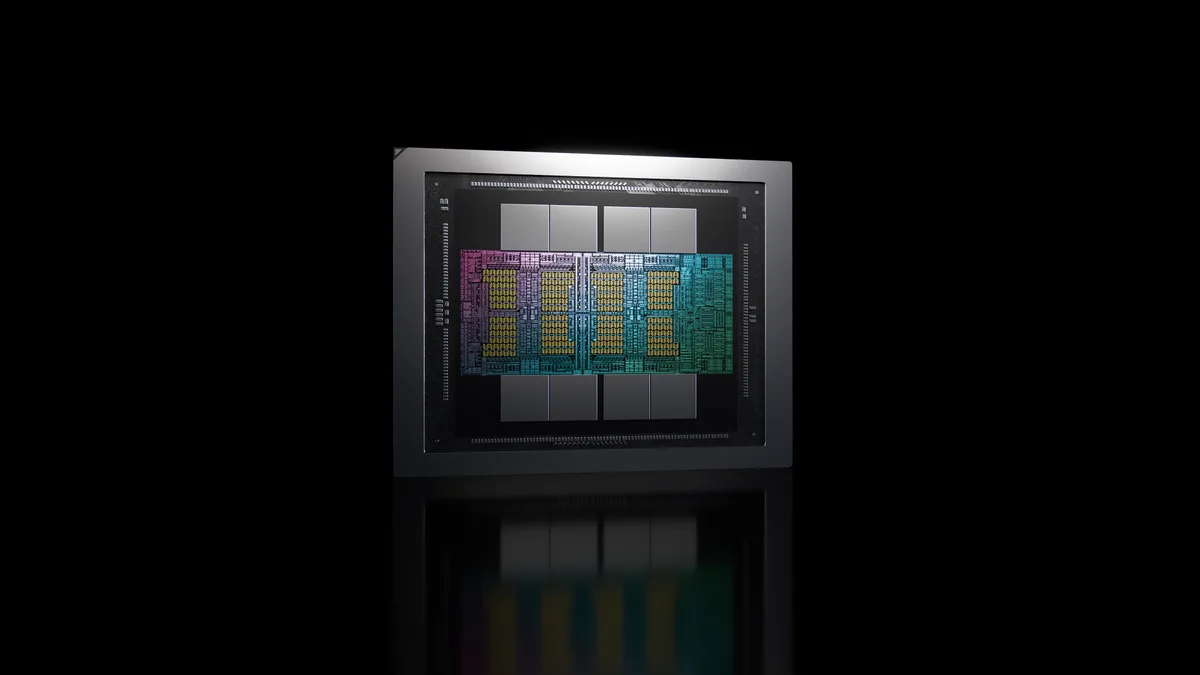
Die symbolische Schallmauer von über 50.000 CUDA-Kernen auf einer einzigen GPU ist offiziell gefallen. Zum Auftakt der Konferenz SC26 (Supercomputing 2026) am 16. November 2026 hat NVIDIA die Rubin HPC vorgestellt, einen spezialisierten Grafikprozessor innerhalb der NVIDIA-Vera-Rubin-Plattform, der wissenschaftliche Simulationen, Ingenieurwesen und komplexe Datenanalysen drastisch beschleunigen soll.
Um diese Packungsdichte für PC-Spieler und Hardware-Enthusiasten greifbar zu machen, lohnt sich ein Blick auf aktuelle High-End-Grafikkarten: Während eine GeForce RTX 5090 (GB202-Blackwell-Chip) mit 21.760 aktiven CUDA-Kernen antritt und wir selbst anspruchsvolle aktuelle Emulations- und Rendering-Szenarien wie in unseren Benchmarks auf einer GeForce RTX 5080 mit deutlich kleineren Ausbaustufen stemmen, verdoppelt die Rubin HPC die Recheneinheiten eines einzelnen Grafikchips auf einen Schlag um mehr als das Zweifache.
Über 50.000 CUDA-Kerne, NVLink der 7. Generation und Sparse-Data-Beschleunigung
Wer zehntausende Recheneinheiten auf einem Silizium-Die vereint, steht vor einem klassischen Flaschenhals der Chiparchitektur: Die Kerne dürfen nicht im Leerlauf verharren, während sie auf verstreute Daten aus dem Arbeitsspeicher warten. Gerade bei Klimamodellen, Strömungssimulationen, Genom-Analysen oder Materialforschungen greifen Algorithmen permanent auf winzige, weit verteilte Datenpunkte innerhalb riesiger Datensätze zu.
Damit die Rubin HPC ihre volle Rechenleistung ohne Speicherstau auf die Straße bringt, kombiniert NVIDIA drei zentrale Neuerungen:
- Hardwareseitige Sparse-Data-Beschleunigung: Eine spezialisierte Einheit hält die mehr als 50.000 CUDA-Kerne kontinuierlich mit Daten gefüttert und beschleunigt wiederkehrende Simulationsmuster wie dünnbesetzte Matrizen (Sparse Matrix), Stencil-Berechnungen, Sortierverfahren und Reduktionen.
- NVIDIA NVLink der 7. Generation: Während die ersten Vera-Rubin-Systeme noch mit NVLink 6 arbeiten, feiert auf der Rubin HPC bereits NVLink 7 Premiere, um den Datendurchsatz zwischen mehreren GPUs massiv zu erhöhen.
- Optimierte NVIDIA-CUDA-X-Bibliotheken: Über angepasste Software-Bibliotheken können KI-Agenten neue Moleküle, Werkstoffe oder Bauteile entwerfen und ihre physikalischen Eigenschaften sofort in der Simulation überprüfen.
Marktstart im Jahr 2028 und die Folgen für kommende Gaming-GPUs
Laut Ian Buck, Vice President für Hyperscale und High-Performance Computing bei NVIDIA, zielt das ausgewogene Verhältnis aus Datentransfer und Rechenkraft direkt auf Forschungsteams ab, die mithilfe autonomer Agenten neue Materialien vor dem Bau physischer Prototypen erproben: „Für Agenten in Wissenschaft und Technik bedeutet eine schnellere Simulation eine schnellere Entdeckung. Rubin HPC beschleunigt die Simulationen, mit denen Agenten Ideen testen und ihre nächsten Schritte steuern.“
Verfügbar sein soll die NVIDIA Rubin HPC im Jahr 2028. In einer Phase, in der das Unternehmen auch strategisch die Weichen für das nächste Jahrzehnt stellt, wie zuletzt die Berichte über die Nachfolgeplanung von Jensen Huang und das Werben um Arm-Chef Rene Haas zeigten, verdeutlicht dieser Zeitplan bis 2028 vor allem eines: Die modernsten Fertigungskapazitäten bei TSMC und schnelle Speicherchips bleiben auf Jahre hinaus fest in der Hand des lukrativen Datacenter- und HPC-Geschäfts, bevor die Rubin-Architektur in abgespeckter Form als kommende GeForce-RTX-60-Generation in unsere Gaming-Rechner einzieht.
Verfügbarkeit der NVIDIA GeForce RTX auf Amazon prüfen→
Mein Prüfstand
Wenn ich mir die Eckdaten der Rubin HPC anschaue, die Ian Buck auf der SC26 präsentiert hat, beeindruckt mich vor allem die Konsequenz beim Datenmanagement. Über 50.000 CUDA-Kerne auf einem einzelnen GPU-Die klingen auf dem Datenblatt gigantisch, wären in der Praxis aber nutzlos, wenn die Speicheranbindung verhungert. Schon bei unseren heutigen Tests mit Blackwell-Karten zeigt sich regelmäßig, dass die Speicherbandbreite oft früher limitiert als die reine Shader-Rohleistung. Dass NVIDIA für 2028 eine dedizierte Sparse-Data-Beschleunigung direkt mit NVLink der 7. Generation koppelt, beweist den Fokus auf echte Effizienz unter Volllast. Für uns PC-Spieler ist das ein spannender technischer Ausblick, auch wenn wir uns wie gewohnt gedulden müssen, bis diese Architektur aus den Rechenzentren im Desktop-Segment ankommt.
Gamer-Pro.de auf Google als bevorzugte Quelle festlegen
Füge gamer-pro.de zu deinen bevorzugten Quellen hinzu, um unsere Hardware-Tests, Guides und Gaming-News vorrangig in Google Discover und der Google-Suche zu sehen.
Hardware- und Linux-Redakteur aus Köln. Lukas „Vex“ baut und vermisst seit vielen Jahren eigene PC-Systeme – vom leisen Small-Form-Factor-Rechner bis zum Linux-Setup unter SteamOS und CachyOS. Auf Gamer-Pro.de prüft er Grafikkarten, Prozessoren, Konsolen-Architekturen und Emulatoren nüchtern auf reale Frametimes, Energieeffizienz und Systemsicherheit.